A 12 de septiembre, el monedero de Nous Portal de un usuario de Hermes había bajado 36,19 $ en lo que iba de mes. Un solo día se llevó 19,30 $ de esa cifra, y el informe de gasto matutino de Hermes cifró ese día en 0,02 $. Las estimaciones del propio Hermes para el mismo periodo sumaban 21,04 $, según su informe en GitHub.
Lo que Hermes envía antes de que escribas
Aparte de pequeñas llamadas secundarias, cada llamada al modelo empieza con la misma carga: el prompt del sistema de Hermes más los esquemas de unas 20 herramientas que ofrece al modelo. La documentación de Hermes habla de entre 4.000 y 8.000 tokens. En nuestra instalación de prueba de Hermes v0.22.2, llegó a unos 12.200 tokens desde la línea de comandos. Los esquemas de herramientas suponían unos 9.000. Desde Telegram, el prompt del sistema es más corto y el total ronda los 11.800.
Los proveedores cobran por token (una palabra o parte de una palabra) y dan los precios por millón de tokens, con precios distintos para la entrada (lo que envía Hermes) y la salida (lo que escribe el modelo). Lo medimos con hermes prompt-size y un modelo simulado que registraba las peticiones de Hermes, como explica la metodología al final de la página.
Esa carga sale con cada llamada, así que hasta una tarea pequeña que le des a Hermes la multiplica. Pedimos a Hermes que escribiera un resumen matutino de tres líneas a partir de la portada de Hacker News, y necesitó cuatro llamadas al modelo. Las tres llamadas principales reenviaron el prompt fijo y fueron creciendo a medida que se arrastraba el texto del feed: unos 12.500, 14.600 y 14.800 tokens. La tarea completa usó unos 42.200 tokens de entrada. Hermes se ahorró una repetición: cuando el mismo comando devolvió la misma salida dos veces, no la reenvió y mandó en su lugar una nota breve que remitía al primer resultado.
Con nuestra tasa de caché, esa entrada cuesta unos 1,4 centavos en Claude Sonnet 5.5. Un resumen al día no llega a 50 centavos al mes en entrada. El resto depende de lo que responda el modelo, a 10 $ por millón de tokens de salida.
La carga de trabajo detrás de cada precio
Todas las cifras de abajo parten de la sesión de programación típica
de la guía de Hermes para ejecutar un modelo local: unos 100.000 tokens de entrada y 20.000 de salida. Llamamos uso ligero a 10 sesiones al mes, uso diario a 30 y uso intensivo a 90. Una sesión de Sonnet 5.5 sale por unos 23 centavos en tokens, así que puedes multiplicar por tu propio número. La misma guía calcula unos 80 centavos por sesión de Claude Sonnet sin enseñar las cuentas; nuestra cifra, más baja, tiene en cuenta la caché a los precios actuales.
Hermes mantiene activada la caché de prompts, así que, tras la primera llamada, ese prompt fijo se factura al precio de lectura de caché: 0,10 $ por millón de tokens en Sonnet 5.5, frente a 2 $ por la entrada nueva. Facturamos el 90 % de la entrada como lecturas de caché y el 10 % como escrituras de caché, o al precio de entrada en los modelos sin precio de escritura. Para Claude, Hermes v0.22.2 viene con la caché de cinco minutos de Anthropic, que escribe a 1,25 veces el precio de entrada, así que esa es la tarifa que usamos. La versión 0.22.4, publicada el 21 de octubre, sigue igual. Si estableces cache_ttl en 1h, las escrituras suben al doble del precio de entrada, y la documentación de Hermes dice que solo compensa cuando tus turnos están separados más de cinco minutos. Un tercer ajuste, auto, elige la caché de una hora para las sesiones en las que escribe una persona y la de cinco minutos para subagentes y cron jobs. Una exportación de facturación de DeepSeek de un usuario, de agosto, mostraba que el 98 % de los tokens de entrada venía de la caché, así que nuestro 90 % es prudente. Sin ninguna caché, los tokens de Sonnet 5.5 costarían 4 $, 12 $ y 36 $ en los tres volúmenes.
Estas cifras no incluyen las herramientas de pago. La búsqueda web, la generación de imágenes y el uso del navegador se cobran por llamada, aparte de los tokens. Según OpenRouter, la búsqueda web para estos modelos de Claude cuesta 1 centavo por llamada.
Cuánto cuesta un mes de modelo
Claude Sonnet 5.5 cuesta lo mismo en ambos catálogos, así que la tabla muestra las dos formas de pagarlo: por token y con un plan de Portal.
| Uso mensual | Sonnet 5.5, por token | Sonnet 5.5, Portal Plus | Kimi K2.6, por token | Servidor de Hermes, Stack 4 |
|---|---|---|---|---|
| Ligero: 10 sesiones (1M de entrada, 0,2M de salida) | $3.14 | $20.00 | $1.68 | $8.99 USD/mespor 3 meses, luego $15.99 USD/mes |
| Diario: 30 sesiones (3M de entrada, 0,6M de salida) | $7.82 | $20.00 | $3.45 | |
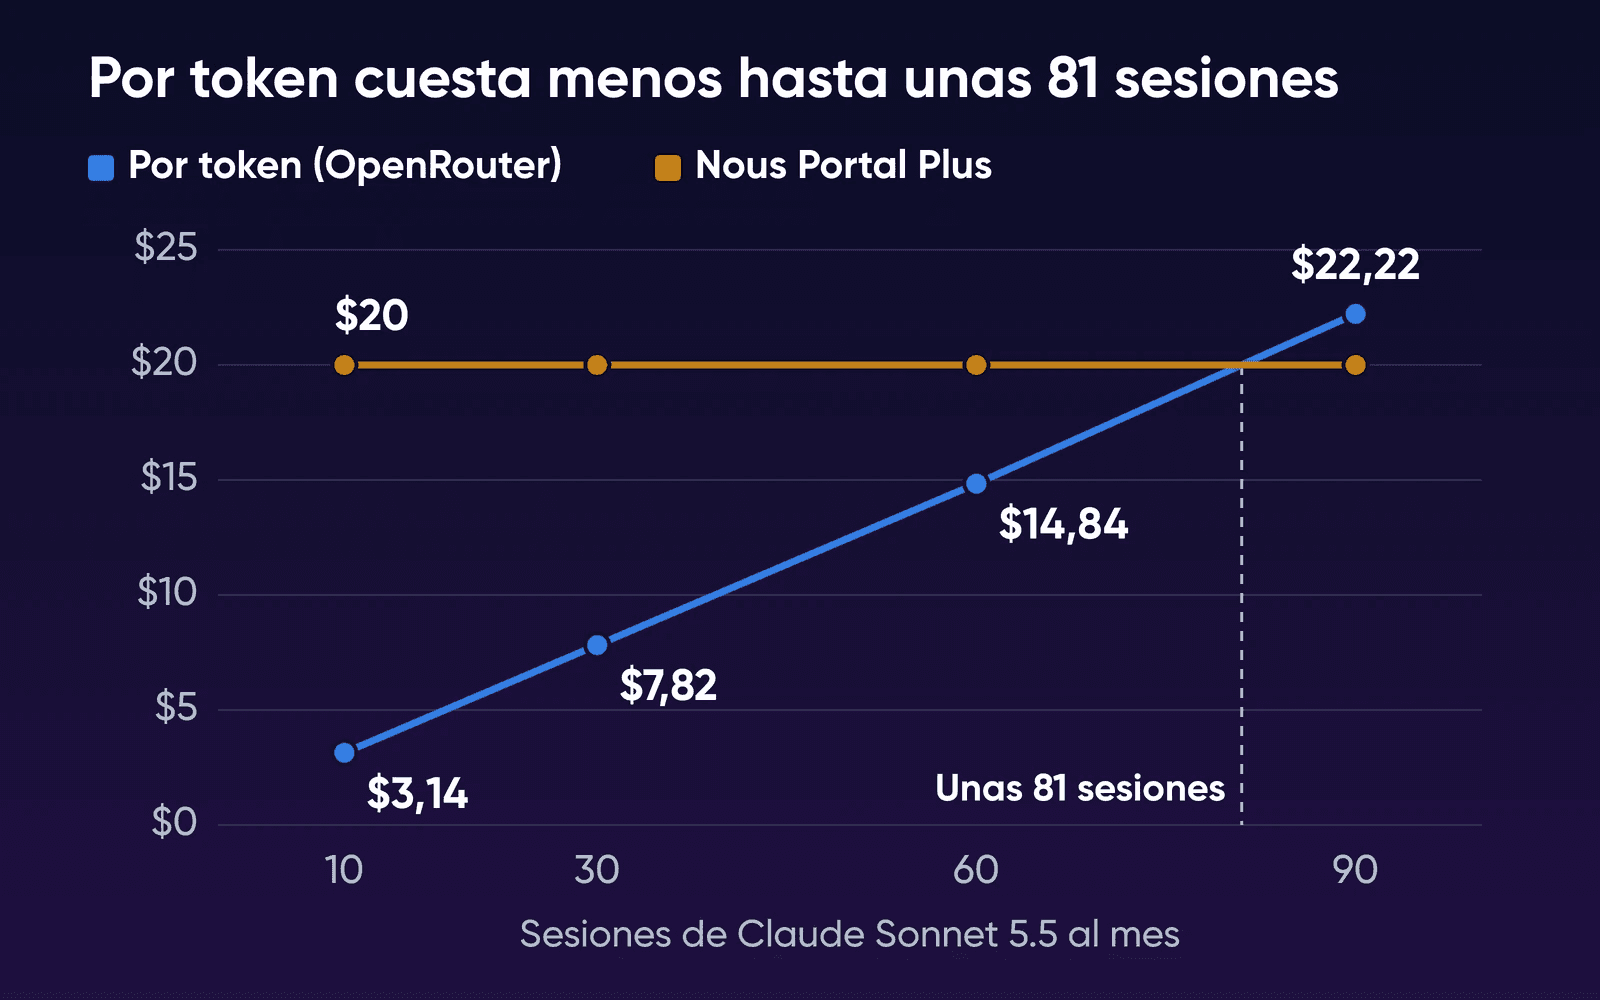
| Intensivo: 90 sesiones (9M de entrada, 1,8M de salida) | $22.22 | $20.00 | $8.74 |
La documentación de Hermes sigue considerando Claude Sonnet 4.6 el mejor modelo agéntico de uso general. A 3 $ de entrada y 15 $ de salida, cuesta la mitad más: 11,74 $ al mes por token con uso diario. En nuestra instalación de prueba, Hermes tenía Claude Opus 4.6 como modelo antes de que configuráramos nada, así que comprueba con qué modelo arranca el tuyo. Si lo dejas así, gastarías unos 18 $ al mes en tokens con uso diario. En sentido contrario, OpenRouter indica que Claude Haiku 5.5 cuesta 0,10 $ de entrada y 0,50 $ de salida por millón de tokens a 22 de octubre, así que el uso diario sale por unos 0,36 $ en tokens, o 1,16 $ con la comisión por tarjeta. Calculamos su precio, pero no probamos lo bien que maneja las herramientas de Hermes.
Una vez que cuentas la caché, la salida es la mayor parte de la factura. Con uso diario, 6,00 $ de los 7,02 $ en tokens de Sonnet 5.5 son salida, así que la longitud de las respuestas del modelo influye más en tu factura que la longitud de la conversación. OpenRouter añade su comisión por tarjeta a cada compra de crédito: un 5,5 %, con un mínimo de 0,80 $. Si compras crédito una vez al mes, son los 0,80 $ de cada factura de uso ligero y diario y 1,16 $ de la de Sonnet con uso intensivo. OpenRouter repercute los precios de los modelos sin margen, así que con una clave directa de Anthropic pagarías los 7,02 $ sin la comisión.
Con un modelo que cuesta lo mismo en ambos, pagar por token sale más barato hasta que tus tokens superan unos 18,96 $ al mes. En Sonnet 5.5 eso son unas 81 sesiones, casi tres al día. Con 60 sesiones seguirías pagando 14,84 $ por token. A partir de 81 sesiones, Plus sale más barato, ya que sus 20 $ compran 22 $ de crédito. El crédito se agota hacia las 94 sesiones. A partir de ahí tendrías que recargar, y como la página de Nous no dice que una recarga compre crédito dólar por dólar, esa parte es una suposición nuestra.
Qué incluye el plan de Portal de 20 $
Un plan de Nous Portal es una suscripción mensual que se paga en forma de crédito. Plus cuesta 20 $ al mes y te da 22 $ de crédito, que gastas a precios de catálogo en modelos y herramientas alojadas. Del crédito sin usar, solo pasan al mes siguiente 10 $. Super cuesta 100 $ por 110 $ de crédito, y Ultra, 200 $ por 220 $. Con nuestra tarifa de Sonnet 5.5, Super solo sale más barato que pagar por token a partir de unas 400 sesiones al mes. Las recargas vienen en importes predefinidos desde 10 $, o en el importe que escribas.
Portal tiene precios más bajos que OpenRouter para algunos modelos, según el catálogo de Nous y el de OpenRouter a 22 de octubre:
| Por millón de tokens, entrada / salida | Nous Portal | OpenRouter |
|---|---|---|
| Kimi K2.6 | $0.4493 / $1.892 | $0.65 / $3.41 |
| Gemma 4 31B | $0.10 / $0.34 | $0.20 / $0.40 |
| DeepSeek V4 Flash | $0.05 / $0.45 | $0.091 / $0.182 |
DeepSeek V4 Flash cuesta más en Portal en la salida. El precio de Kimi en Nous ha subido desde los 0,4323 $ y 1,82 $ que tenía cuando lo calculamos por primera vez el 16 de octubre. Su ficha sigue mostrando un precio original
de 0,95 $ y 4,00 $, así que ese descuento podría terminar. Con estos volúmenes, el descuento ahorra menos de lo que cuesta el plan, como muestra la tabla de abajo. El informe de GitHub mencionado antes también descubrió que Portal cobraba en una ruta de DeepSeek 11 veces la tarifa de entrada que indicaba su catálogo, así que compara tu monedero con el catálogo después de la primera semana.
El otro motivo para contratar un plan es el Tool Gateway, que cubre búsqueda web, scraping, generación de imágenes, uso del navegador y voz, cada uno con precio por uso a partir de los mismos créditos. La documentación de Hermes considera Portal la forma recomendada de ejecutar Hermes.
| Nous Portal Plus | OpenRouter, por token | Modelo local en tu servidor | |
|---|---|---|---|
| Kimi K2.6, un mes de uso diario | 20,00 $ (1,47 $ de crédito usado) | $3.45 | Sin precio |
| Gemma 4 31B, un mes de uso diario | 20,00 $ (0,50 $ de crédito usado) | $1.64 | 0 $ en tokens |
| DeepSeek V4 Flash, un mes de uso diario | 20,00 $ (0,42 $ de crédito usado) | $0.99 | Sin precio |
| Precios de los tokens | Precios de catálogo, algunos descuentos exclusivos de Portal | El precio del proveedor, sin margen | Ninguno |
| Mínimo mensual | $20 | Ninguno | Ninguno |
| Comisión por tarjeta | No se indica | 5,5 %, mínimo de 0,80 $ | Ninguno |
En qué se van los tokens
Los subagentes son los que más consumen. La documentación sobre delegación de Hermes dice que un lote de subagentes en paralelo suele gastar la gran mayoría de los tokens de una ejecución, y recomienda asignar al trabajo delegado un modelo más barato que el del chat principal. Las tareas secundarias, como los títulos de sesión, la compresión de contexto y la lectura de capturas de pantalla, también van a tu modelo principal a menos que configures uno más barato en auxiliary dentro de la configuración. Nuestro resumen hizo una de esas llamadas.
Las tareas programadas también suman, porque siguen ejecutándose mientras no estás.
Cron jobs run repeatedly and autonomously, so a modest per-run cost can accumulate unnoticed.
Puedes darle a un cron job un pequeño script de comprobación previa que se ejecute antes que el modelo. Cuando la última línea de salida del script es esta, Hermes se salta el agente en esa ejecución, y la propia comprobación wakeAgent cuesta 0 $:
{ "wakeAgent": false }Eso encaja con una tarea que consulta cada pocos minutos, pero solo necesita el modelo cuando algo ha cambiado. En nuestra VM, un cron job solo de script creado con --no-agent se ejecutó según lo previsto sin ningún modelo conectado. La misma documentación de cron advierte de que incluir las herramientas de navegador y delegación en una pequeña tarea de noticias infla la lista de herramientas que se envía en cada llamada. Los esquemas de herramientas eran la mayor parte del prompt fijo que medimos, así que da a cada tarea solo las herramientas que usa.
Cada cambio con /model a mitad de conversación reinicia la caché de prompts, así que el siguiente mensaje vuelve a leer toda la conversación al precio de entrada completo. En OpenRouter gastas el crédito que has comprado, así que, según lo entendemos, una tarea descontrolada se detiene cuando se agota ese saldo, siempre que dejes desactivada su recarga automática.
Usar un modelo local
Hermes Agent VPS Hosting no incluye ningún modelo. Hermes llama a la API de tu proveedor, y la página del producto indica que en el propio servidor no se ejecuta ningún modelo. Con acceso root puedes añadir uno: instala Ollama y apunta Hermes hacia él, como explica la guía de modelos locales de Hermes.
Esa guía elige gemma4:31b para el trabajo de agente. Es el único de los cuatro modelos de su tabla que puede llamar a herramientas, algo que Hermes necesita para ejecutar comandos y navegar. Necesita unos 20 GB de disco y 24 GB de memoria o más. En nuestros planes, eso es Stack 32, con 32 GB de memoria y 8 vCPU. Los 16 GB de Stack 16 no bastan. Hermes también necesita que el contexto del modelo sea de al menos 64.000 tokens. Antes de pasarte a un modelo local para ahorrar, compara lo que Stack 32 cuesta de más respecto a Stack 4 en la lista de planes con la fila de Gemma 4 31B de la tabla comparativa de arriba.
En una CPU, un modelo de 31B escribe entre 2 y 5 tokens por segundo, según la documentación de Hermes, y la misma guía dice que los grandes modelos en la nube rinden notablemente mejor en trabajos de varios pasos muy complejos. Con 20.000 tokens de salida por sesión, eso son entre 67 y 167 minutos de escritura cada vez, o entre 33 y 83 horas al mes con uso diario. Además, el modelo tiene que leer el prompt fijo en cada llamada, así que en hardware lento el primer turno puede quedarse en silencio durante minutos.
Modelo local
- Sin factura de tokens, sea cual sea el volumen
- Los prompts y los datos se quedan en tu servidor
Lo que te exige
- Stack 32 en lugar de Stack 4, para gemma4:31b
- Entre 2 y 5 tokens por segundo en CPU, es decir, de una a tres horas de escritura por sesión
Cómo pagar
Paga por token si
Tu gasto mensual en tokens se mantiene por debajo de lo que cuesta un plan Plus. En nuestros cálculos, eso incluía el uso diario de Sonnet 5.5 y todos los meses de Kimi o Gemma. Compra crédito de OpenRouter una vez al mes, ya que su comisión mínima por tarjeta se aplica a cada compra.
Contrata un plan de Nous Portal si
Usas Claude Sonnet 5.5 en más de unas 81 sesiones al mes. También te conviene si quieres búsqueda web, imágenes y uso del navegador con el mismo saldo que tus modelos.
Usa un modelo local si
Tus tareas pueden ejecutarse durante la noche y tus datos no deben salir del servidor. Necesitarás Stack 32 y, en CPU, cada sesión tardará de una a tres horas en escribir su respuesta.
Qué cubre la factura del servidor
En nuestra VM de prueba (no un servidor de DreamHost), Hermes se mantuvo en reposo en unos 557 MiB tras 10 minutos, con su gateway y su panel en marcha y sin clave. A la VM aún le quedaban libres unos 3 GB de sus 4 GB. La mediana de su uso de CPU se mantuvo por debajo del 1 % y la imagen ocupó unos 4,5 GB de disco.
| Cómo se ejecuta el modelo | Medido en nuestra VM de prueba | Plan |
|---|---|---|
| Modelo por API: Hermes y su panel | Unos 557 MiB en reposo, menos del 1 % de CPU | Stack 4 |
| Modelo por API, más gateways de mensajería y tareas más pesadas | Sin medir (el plan siguiente) | Stack 8 |
| gemma4:31b local a través de Ollama | Sin medir (24 GB o más, según la documentación de Hermes) | Stack 32 |
La documentación de Docker de Nous fija el mínimo del contenedor en 1 GB de memoria, 1 núcleo de CPU y 500 MB de disco para sus datos, y recomienda de 2 a 4 GB y 2 núcleos. La propia página del producto aconseja empezar con Stack 4 y subir de plan cuando añadas gateways o tareas más pesadas. El ejemplo de Docker de Nous limita el contenedor a 4 GB de memoria y 2 CPU, el mismo tamaño que Stack 4.
Hermes guarda su memoria, sus habilidades y su historial de sesiones en el almacenamiento raíz de tu servidor. Según la página del producto, no se garantiza que ese almacenamiento sobreviva a una reconstrucción, así que sincroniza esos archivos en otro lugar. Las actualizaciones y los parches corren de tu cuenta. El soporte de DreamHost está disponible 24/7 para el hardware, la red y la conectividad. Tú gestionas el sistema operativo, el software y la configuración, y la página del producto describe Hermes como software de código abierto con soporte de la comunidad. Si todavía estás eligiendo un agente, consulta Hermes frente a OpenClaw, probados en paralelo. Si ya pagas Claude Code, consulta Hermes Agent frente a Claude Code.
Hermes Cloud es la alternativa alojada de Nous. Se factura a diario con crédito de Nous: el cómputo por segundo mientras tu agente se ejecuta, el almacenamiento tanto si se ejecuta como si no, y los modelos y las herramientas aparte. Sus precios no se muestran fuera de Nous Portal, así que inicia sesión allí para compararlos.
Cómo lo medimos
DreamHost hizo la prueba el 16 de octubre de 2026, en una VM Linux a través de Colima en un Mac con Apple silicon. La VM ejecutaba Ubuntu 24.04.4 en arm64, con 2 vCPU, unos 4 GB de memoria y Docker 29.5.2. Hermes v0.22.2 se ejecutó en el contenedor oficial de Nous, fijado por digest. Usamos el ejemplo de Docker de Nous con el gateway, el panel y los límites de 4 GB y 2 CPU del ejemplo. No introdujimos ninguna clave de API, cuenta ni token de mensajería. Las cifras de memoria y CPU son la mediana de 12 muestras de docker stats tomadas con 5 segundos de diferencia, a los 2 y a los 10 minutos del arranque, en una sola ejecución. El panel respondió 10 segundos después del comando de arranque.
Para el prompt, hermes prompt-size dio el tamaño en bytes del prompt del sistema y de los esquemas de herramientas. Contamos los tokens de la primera solicitud que Hermes envió a un pequeño modelo simulado en la misma VM, que registraba cada solicitud. Para Telegram, los esquemas de herramientas son los mismos, y escalamos el prompt del sistema, más corto, según su número de bytes. Para el resumen informativo, el modelo simulado pidió a Hermes que obtuviera dos veces el feed de Hacker News con curl y luego respondió. Gemma en OpenRouter no tiene precio de caché, así que toda su entrada se factura al precio de entrada. Los recuentos de tokens usan el tokenizador o200k de OpenAI, y Claude, Kimi y Gemma cuentan cada uno de forma un poco distinta.
La ejecución no dio ninguna cifra en dólares: cada precio de esta página es un cálculo nuestro a partir de los dos catálogos de modelos. Volvimos a comprobar todos los precios, planes y fuentes el 21 de octubre de 2026, y solo había cambiado el precio de Kimi K2.6 en Nous. Hermes v0.22.4 salió el 21 de octubre y no repetimos la prueba con esa versión. El 22 de octubre volvimos a consultar ambos catálogos de modelos, y solo había cambiado el precio de entrada de DeepSeek V4 Flash en Nous, que bajó a 0,05 $. También contrastamos cada plan, precio y afirmación de producto de DreamHost que aparece aquí con la página actual del hosting VPS para Hermes Agent. Un modelo real puede llamar a más o menos herramientas que nuestro modelo simulado, y la salida del resumen informativo no está medida. Nuestros servidores usan procesadores AMD EPYC, que son x86. Nuestra imagen de Hermes se ejecuta en Debian 13 tras Caddy, no en la configuración de contenedor que probamos, así que toma las cifras de memoria como una aproximación cercana. Era una instalación nueva, todavía sin memoria ni historial, y Hermes añade la memoria al prompt a medida que se llena. No ejecutamos ningún modelo local.
Preguntas frecuentes sobre el coste de Hermes Agent
¿Hermes Agent es gratis?
Sí. Hermes es de código abierto con licencia MIT, y puedes ejecutarlo donde quieras sin coste. Pagas a tu proveedor de modelos por los tokens, salvo que ejecutes un modelo local, y pagas la máquina en la que se ejecuta Hermes.
¿Cuál es el modelo más barato para usar con Hermes?
El plan Free de Nous Portal solo ejecuta modelos gratuitos, 8 en su catálogo a 21 de octubre de 2026. El Gemma 4 31B gratuito de OpenRouter permite 50 solicitudes al día, o 1000 tras comprar 10 $ de crédito, y Hermes hace varias llamadas por turno. Nuestro modelo de pago más barato, DeepSeek V4 Flash, cuesta 0,99 $ al mes con uso diario, en su mayor parte por la comisión de tarjeta de 0,80 $ de OpenRouter.
¿Puedo usar mi suscripción de Claude o ChatGPT con Hermes?
Claude Pro no: no puede iniciar sesión, y Claude Max solo gasta los créditos de uso adicional que compres, según la documentación de Hermes. Un plan de ChatGPT sí puede iniciar sesión, aunque la documentación de Hermes no aclara de qué saldo consume. Si lo que quieres sobre todo es tener varios agentes de Claude a la vez, compara los equipos de agentes de Claude Code con Paperclip.
¿Merece la pena la suscripción a Nous Portal?
Plus compensa cuando superas unos 19 $ al mes en tokens, unas 81 sesiones de Claude Sonnet 5.5, o si quieres que la búsqueda web, las imágenes y el uso del navegador se cobren del mismo crédito. Por debajo de eso, pagar por token sale más barato.
¿Cuál es el mejor modelo local para usar con Hermes?
La guía de Ollama de Hermes elige gemma4:31b, el único modelo de su tabla que puede llamar a herramientas. Necesita 24 GB de memoria o más, así que requiere Stack 32, y en una CPU escribe unos 2 a 5 tokens por segundo.
¿Cómo veo lo que me está costando Hermes?
Empieza por el panel de tu proveedor y luego mira las cifras del propio Hermes. Dentro de Hermes, /usage y /insights muestran el gasto, y una ejecución puntual con --usage-file escribe un total general que incluye las llamadas en segundo plano de Hermes. Compara ambas cifras después de tu primera semana.
Fuentes
- Hermes Agent VPS Hosting, DreamHost, consultado el 22 oct 2026. dreamhost.com/hosting/vps/hermes-agent
- Nous Portal: plans and model prices, Nous Research, consultado el 22 oct 2026. portal.nousresearch.com
- Nous inference API model catalog, Nous Research, consultado el 22 oct 2026. inference-api.nousresearch.com/v1/models
- Hermes Cloud, Nous Research, consultado el 21 oct 2026. portal.nousresearch.com/cloud
- OpenRouter model catalog, OpenRouter, consultado el 22 oct 2026. openrouter.ai/api/v1/models
- FAQ: fees and free models, OpenRouter, consultado el 21 oct 2026. openrouter.ai/docs/faq
- Nous Portal, Hermes Agent docs, consultado el 21 oct 2026. hermes-agent.nousresearch.com/docs/integrations/nous-portal
- AI Providers, Hermes Agent docs, consultado el 21 oct 2026. hermes-agent.nousresearch.com/docs/integrations/providers
- Configuration, Hermes Agent docs, consultado el 21 oct 2026. hermes-agent.nousresearch.com/docs/user-guide/configuration
- Run Hermes Locally with Ollama, Hermes Agent docs, consultado el 21 oct 2026. hermes-agent.nousresearch.com/docs/guides/local-ollama-setup
- Local LLM guide, Hermes Agent docs, consultado el 21 oct 2026. hermes-agent.nousresearch.com/docs/guides/local-llm-on-mac
- Slash commands, Hermes Agent docs, consultado el 21 oct 2026. hermes-agent.nousresearch.com/docs/reference/slash-commands
- CLI Commands, Hermes Agent docs, consultado el 21 oct 2026. hermes-agent.nousresearch.com/docs/reference/cli-commands
- Scheduled Tasks, Hermes Agent docs, consultado el 21 oct 2026. hermes-agent.nousresearch.com/docs/user-guide/features/cron
- Delegation, Hermes Agent docs, consultado el 21 oct 2026. hermes-agent.nousresearch.com/docs/user-guide/features/delegation
- Docker, Hermes Agent docs, consultado el 21 oct 2026. hermes-agent.nousresearch.com/docs/user-guide/docker
- FAQ, Hermes Agent docs, consultado el 21 oct 2026. hermes-agent.nousresearch.com/docs/reference/faq
- Hermes Agent releases, Nous Research (GitHub), consultado el 21 oct 2026. github.com/NousResearch/hermes-agent/releases
- Hermes default settings, v0.22.4 source, Nous Research (GitHub), consultado el 21 oct 2026. github.com/NousResearch/hermes-agent/blob/v0.22.4/hermes_cli/config_defaults.py
- Token usage tracking underreports actual API spend (issue #87450), Hermes Agent (GitHub), consultado el 21 oct 2026. github.com/NousResearch/hermes-agent/issues/87450
- Spend accounting understates real Nous billing (issue #108936), Hermes Agent (GitHub), consultado el 21 oct 2026. github.com/NousResearch/hermes-agent/issues/108936
- Show per-job token usage and average cost on the Crons dashboard (issue #106615), Hermes Agent (GitHub), consultado el 21 oct 2026. github.com/NousResearch/hermes-agent/issues/106615
- gemma4 tags, Ollama, consultado el 21 oct 2026. ollama.com/library/gemma4/tags